
Agents IA : comment automatiser réellement les tâches d’un site web ?
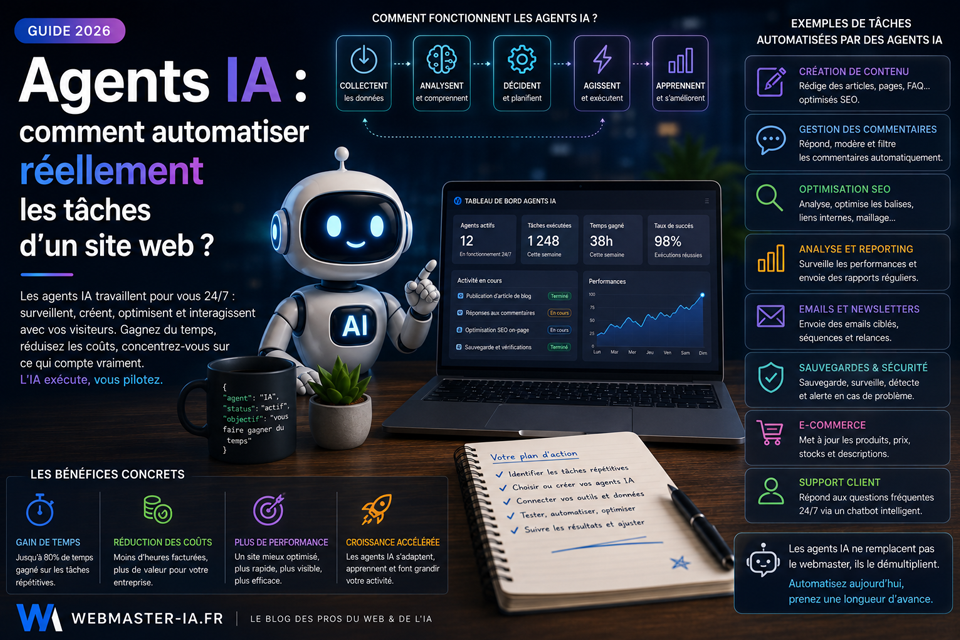
Un agent IA n’automatise pas un site parce qu’il est intelligent, mais parce que quelqu’un a défini avec précision ce qu’il a le droit de faire, sur quoi, et comment on vérifie. La différence entre une démonstration spectaculaire et une automatisation qui tourne en production tient entièrement dans ce travail de cadrage.
Ce guide décrit ce qu’un agent peut réellement prendre en charge sur un site web, la mécanique qui le rend possible, et la méthode de délégation graduée qui permet de lui confier des écritures sans perdre le contrôle. Il ne cite aucun chiffre de marché et ne recommande aucun produit.
Ce que couvre ce guide
- La distinction opératoire entre un chatbot, un workflow et un agent, et la règle qui permet de choisir.
- Les cinq raisons pour lesquelles les tentatives échouent, toutes antérieures au code.
- Un catalogue de tâches réellement automatisables, par famille, avec déclencheur, droits requis et point de validation.
- La mécanique interne : boucle d’exécution, exposition des actions par MCP, anatomie d’un outil bien conçu.
- La délégation graduée en quatre paliers, dix étapes de mise en œuvre, la sécurité et les indicateurs de suivi.
Agent, workflow, chatbot : trois choses différentes
Les trois termes circulent comme des synonymes dans les discussions de départ. Ils désignent des dispositifs qui ne règlent pas le même problème, ne coûtent pas la même chose et ne comportent pas les mêmes risques.
Le chatbot répond
Il reçoit une question, va chercher des passages dans vos contenus, rédige une réponse. Il ne modifie rien. Son risque est éditorial : dire une chose fausse. Son périmètre se borne par le prompt système et par le corpus fourni. Le sujet est traité sur Chatbot IA.
Le workflow exécute une séquence fixée
Un événement déclenche une suite d’étapes que vous avez écrites : quand un formulaire est reçu, extraire ces champs, appeler ce modèle pour classer la demande, créer cette fiche, envoyer cette notification. L’ordre est déterminé à l’avance. Le modèle n’intervient qu’à une ou deux étapes, là où il faut comprendre du texte libre.
C’est généralement la solution la moins coûteuse et la plus prévisible. Elle couvre une partie des besoins formulés comme « il nous faudrait un agent ». La mécanique est détaillée sur Workflows IA.
L’agent décide de la séquence
On lui donne un objectif et une boîte à outils. Il choisit lui-même quels outils appeler, dans quel ordre, combien de fois, et quand s’arrêter. C’est ce qui le rend utile sur les tâches dont on ne peut pas écrire la séquence à l’avance, parce qu’elle dépend de ce qu’il va trouver en chemin.
C’est aussi ce qui le rend coûteux et délicat : chaque décision est une occasion de se tromper, et le nombre d’appels au modèle n’est pas connu à l’avance. Le fonctionnement est décrit sur Agents IA.
La règle de choix
| Critère | Chatbot | Workflow | Agent |
|---|---|---|---|
| Modifie vos données | Non | Oui, selon un plan écrit | Oui, selon ses propres décisions |
| Séquence des étapes | Sans objet | Fixée par vous | Déterminée à l’exécution |
| Coût par exécution | Prévisible | Prévisible | Variable |
| Facilité de diagnostic | Bonne | Bonne | Dépend de la journalisation |
| Risque principal | Réponse fausse | Enchaînement mal conçu | Action non prévue sur vos données |
| Quand le choisir | Le visiteur a une question | La procédure est stable | La procédure dépend du contenu rencontré |
La règle tient en une phrase : si vous pouvez dessiner la procédure sur une feuille avec des flèches et des conditions, faites un workflow. L’agent devient pertinent quand cette feuille comporterait une case « ça dépend de ce qu’on trouve ».
Pourquoi les tentatives échouent
Les projets d’agent qui n’aboutissent pas partagent des causes récurrentes, et toutes se situent avant l’écriture du code.
- Aucune tâche n’a été nommée. « Automatiser la gestion du site » n’est pas une tâche. « Publier les fiches produits reçues du fournisseur » en est une. Tant que la formulation reste au niveau du domaine, il n’y a rien à confier.
- Les actions nécessaires n’existent pas. Un agent ne clique pas dans une interface, il appelle des fonctions. Si votre outil n’expose aucune action, il n’y a rien à appeler, et le chantier réel est de créer cette exposition.
- Les droits sont accordés en bloc. Ouvrir tout d’un coup pour aller vite produit un dispositif qu’on n’ose plus laisser tourner. Un serveur trop permissif est ensuite difficile à restreindre, parce que des usages se sont installés dessus entre-temps.
- Rien n’est journalisé. Quand une action inattendue survient et que personne ne peut reconstituer la suite d’appels qui y a mené, le diagnostic est impossible et la confiance ne revient pas.
- Le critère de fin n’est pas écrit. Sans lui, l’agent s’arrête quand il estime avoir fait le tour, ce qui ne correspond pas forcément à votre attente, et personne ne peut dire si la tâche est terminée.
Une sixième cause mérite d’être isolée parce qu’elle ne se voit qu’à l’usage : la tâche confiée n’en était pas une pour l’agent, mais pour un workflow. Le dispositif fonctionne, coûte plus cher que nécessaire, et devient imprévisible sans contrepartie.
Ce qu’un agent peut réellement faire sur un site
Six familles regroupent les usages les plus courants. Pour chacune, la question utile n’est pas « est-ce possible » mais « quel droit cela suppose, et qui valide ».
1. Publication et maintenance éditoriale
C’est une famille où les agents rendent des services concrets, parce que le travail y est répétitif et que les erreurs sont réversibles.
- Créer un brouillon structuré à partir d’un document source, avec titres, sections et métadonnées renseignées.
- Mettre à jour une information qui apparaît sur plusieurs pages, en signalant chaque occurrence trouvée avant de modifier.
- Repérer les contenus périmés, contradictoires ou redondants dans un corpus ancien, et proposer un plan de traitement.
- Compléter les textes alternatifs d’images manquants sur un stock existant.
- Proposer des liens internes pertinents entre pages, à valider avant application.
- Reprendre la mise en forme d’anciens contenus importés pour l’aligner sur la charte actuelle.
Sur WordPress, ces actions passent par les interfaces standard du CMS. Le détail figure sur MCP pour WordPress, et l’équivalent sur d’autres systèmes sur MCP pour CMS.
2. Maintenance technique et qualité
Des tâches que personne n’a le temps de faire régulièrement, et dont l’absence se paie lentement.
- Parcourir le site à la recherche de liens internes cassés, puis proposer la cible correcte quand elle existe.
- Détecter les pages orphelines, celles vers lesquelles aucun lien interne ne pointe.
- Signaler les images sans texte alternatif, les titres dupliqués, les hiérarchies de titres incohérentes.
- Contrôler après une mise à jour que les pages sensibles répondent toujours et affichent ce qu’elles doivent afficher.
- Préparer un récapitulatif hebdomadaire des anomalies, classées par gravité.
Cette famille se prête bien à un premier palier en lecture seule : l’agent constate et rapporte, un humain corrige. Les tâches récurrentes de ce type sont traitées sur Automatisation des tâches web.
3. Référencement et données structurées
- Compléter les titres SEO et les méta-descriptions manquants, en respectant les longueurs attendues.
- Vérifier la cohérence entre le balisage de données structurées et le contenu visible de la page.
- Repérer les pages qui se disputent la même requête et documenter le conflit.
- Contrôler l’accessibilité technique du site aux robots des moteurs, y compris ceux des moteurs génératifs.
Une précaution s’impose ici : un agent qui réécrit des balises en masse peut dégrader un positionnement acquis. Le palier brouillon est indiqué. La méthode d’audit préalable est décrite sur Audit SEO et IA, et l’usage éditorial sur SEO avec l’intelligence artificielle.
4. Catalogue et e-commerce
- Enrichir des fiches produits à partir de caractéristiques techniques brutes fournies par un fournisseur.
- Harmoniser les attributs d’un catalogue importé : unités, formats, catégories, correspondances.
- Repérer les produits dont la description ne correspond plus aux caractéristiques enregistrées.
- Préparer les traductions de fiches pour une boutique multilingue, avant relecture.
La règle de base dans cette famille : toute donnée affichée doit provenir de votre base, jamais de la mémoire du modèle. Un agent qui complète une caractéristique manquante par déduction crée un risque commercial. Le sujet est développé sur Automatisation e-commerce et IA et e-commerce.
5. Demandes entrantes et relation client
- Lire une demande reçue par formulaire, en extraire les éléments structurants et créer la fiche correspondante.
- Rechercher l’historique du contact dans plusieurs outils avant de préparer un projet de réponse.
- Router la demande vers le bon service selon des règles métier explicites.
- Signaler les demandes qui sortent des cas prévus plutôt que de les traiter au jugé.
C’est ici que la frontière entre agent et workflow est la plus ténue. Si la recherche d’historique impose de décider quel outil interroger selon ce qu’on a déjà trouvé, l’agent se justifie. Sinon, un workflow suffit. Voir IA et CRM.
6. Supervision et rapports
Un agent qui n’écrit rien mais qui lit beaucoup rend déjà service : consolider des indicateurs venus de plusieurs sources, rédiger une note de suivi périodique, signaler ce qui a changé depuis la dernière fois, préparer l’ordre du jour d’un point de pilotage à partir des anomalies constatées.
Cette famille est un bon terrain d’apprentissage : un risque faible, une valeur immédiate, et surtout l’occasion d’observer comment l’agent raisonne avant de lui accorder le moindre droit d’écriture.
Récapitulatif
| Famille | Déclencheur habituel | Droits requis | Validation humaine |
|---|---|---|---|
| Publication éditoriale | Arrivée d’un document source | Création en brouillon | Avant publication |
| Maintenance technique | Planification périodique | Lecture seule au départ | Sur le rapport produit |
| Référencement | Publication ou audit périodique | Écriture sur les métadonnées | Avant application en masse |
| Catalogue | Import fournisseur | Écriture sur les fiches | Sur échantillon puis par lot |
| Demandes entrantes | Soumission d’un formulaire | Création dans l’outil de destination | Avant tout envoi au client |
| Supervision | Planification périodique | Lecture seule | Lecture du rapport |
Comment cela fonctionne
La boucle d’exécution
Un agent tourne en boucle. Il reçoit un objectif et la liste des outils disponibles. Il choisit un outil et l’appelle. Il reçoit le résultat, qui vient s’ajouter à ce qu’il sait. Il décide alors s’il appelle un autre outil ou s’il rend sa réponse. Cette boucle se répète jusqu’à ce que l’objectif soit atteint, qu’une limite soit franchie, ou qu’une erreur bloque la suite.
Deux conséquences pratiques découlent de ce fonctionnement. Le coût d’une exécution n’est pas connu à l’avance, puisque le nombre de tours dépend de ce que l’agent rencontre. Et une limite d’itérations doit être posée, faute de quoi une boucle mal engagée tourne jusqu’à épuisement du budget.
Exposer les actions : le rôle de MCP
Pour qu’un agent agisse sur votre site, il faut lui donner des actions appelables. Le Model Context Protocol, protocole ouvert publié par Anthropic, définit une façon standard d’exposer trois choses : des outils, c’est-à-dire des actions exécutables ; des ressources, c’est-à-dire des contenus lisibles ; et des prompts, c’est-à-dire des modèles d’instruction préparés.
L’intérêt pratique tient à la réutilisation : un système exposé une fois devient utilisable par les clients qui implémentent le protocole, sans développement spécifique à chacun. Les principes de conception d’un serveur sont détaillés sur Serveurs MCP, et l’articulation avec les interfaces existantes sur MCP et API.
Anatomie d’un outil bien conçu
La qualité d’un agent dépend moins du modèle que de la façon dont ses outils sont décrits. Un outil exposé comporte quatre éléments, et chacun a un effet direct sur le comportement observé.
- Un nom explicite, qui dit l’action et son objet. Un nom vague conduit l’agent à l’appeler à contretemps.
- Une description qui précise quand l’utiliser et quand ne pas l’utiliser. La seconde moitié est celle qu’on oublie, et c’est souvent elle qui évite les appels indésirables.
- Des paramètres typés et contraints, avec les valeurs autorisées. Un paramètre libre là où trois valeurs suffisent ouvre la porte aux incohérences.
- Des messages d’erreur qui expliquent la cause et la correction attendue. Un agent qui reçoit « échec » réessaie à l’identique ; un agent qui reçoit « la date doit être postérieure à celle de création » corrige.
Un principe de granularité aide à découper : un outil doit correspondre à une action métier complète, pas à une opération technique isolée. « Publier un article » vaut mieux que trois outils qui écrivent chacun un champ.
Le contexte de la tâche
Tout ce que l’agent a lu s’accumule au fil des tours. Sur une tâche longue, cette accumulation devient coûteuse et finit par noyer l’objectif initial. Deux pratiques limitent l’effet : ne renvoyer dans le résultat d’un outil que ce qui sert à la décision suivante, plutôt que l’objet complet ; et découper une tâche longue en plusieurs exécutions courtes, dont la sortie de l’une devient l’entrée de la suivante.
La délégation graduée : quatre paliers
C’est le principe qui distingue un déploiement tenable d’une expérimentation abandonnée. On ne demande pas à un agent d’être fiable, on organise la progression de ce qu’on lui confie.
| Palier | Ce que l’agent peut faire | Ce qu’on observe | Condition pour passer au suivant |
|---|---|---|---|
| 1. Lecture seule | Consulter, analyser, produire un rapport | La pertinence de ce qu’il repère | Les rapports sont exacts et utiles |
| 2. Brouillon | Créer du contenu non publié, proposer des modifications | La part de propositions retenues sans retouche | Les propositions passent le plus souvent telles quelles |
| 3. Écriture réversible | Modifier ce qui dispose d’un historique et d’un retour arrière | La fréquence des retours arrière | Les corrections deviennent rares |
| 4. Écriture engageante | Agir sur ce qui sort de votre périmètre ou ne se défait pas | Chaque action, individuellement | Palier rarement atteint, et c’est normal |
Le quatrième palier mérite une remarque. Envoyer un message à un client, valider une commande, supprimer définitivement un contenu : ces actions ne se défont pas. Certaines organisations décident de ne jamais y aller, et conservent une validation humaine sur ces gestes. Ce n’est pas un aveu d’échec, c’est un choix de conception raisonnable.
Une nuance utile : le palier ne se décide pas pour l’agent en général, mais outil par outil. Le même agent peut lire librement, créer des brouillons, et n’avoir aucun droit sur la suppression.
Mise en œuvre, étape par étape
Étape 1 : choisir une tâche nommable
Le test est simple : la tâche tient-elle en une phrase avec un verbe d’action, un objet et une condition de déclenchement ? « Quand une fiche fournisseur arrive, créer le brouillon de la page produit correspondante » passe le test. « Améliorer le contenu du site » ne le passe pas.
Choisissez de préférence une tâche qui revient, qui ennuie la personne qui la fait, et dont l’erreur se rattrape. Ces trois critères réunis donnent un premier chantier où l’apprentissage coûte peu.
Étape 2 : écrire la procédure comme pour un nouveau collaborateur
Demandez à la personne qui fait la tâche aujourd’hui de l’écrire pas à pas, y compris les cas particuliers qu’elle traite sans y penser. C’est souvent l’étape la plus révélatrice du projet : elle fait apparaître les règles implicites, les exceptions non documentées et les décisions qui reposaient sur une connaissance personnelle.
Ce document sert deux fois. Il devient la base des instructions données à l’agent, et il vous reste utile même si le projet s’arrête là.
Étape 3 : inventorier les actions nécessaires
Reprenez la procédure et soulignez chaque geste qui touche un système : lire une fiche, chercher dans un catalogue, créer une page, envoyer une notification. Chaque geste souligné devient un outil à exposer, ou un outil qui existe déjà.
Cet inventaire révèle souvent que le chantier réel n’est pas l’agent mais l’exposition des actions. C’est une bonne nouvelle : cette exposition sert ensuite à d’autres usages, y compris à des automatisations sans agent.
Étape 4 : exposer les actions proprement
Deux voies existent. Passer par les interfaces déjà disponibles de vos outils, souvent des API documentées, ce qui évite de réécrire une logique métier. Ou construire un serveur MCP qui vient se poser devant l’existant et le présente sous forme d’actions métier. La seconde voie coûte davantage au départ et se réutilise ensuite.
Dans les deux cas, appliquez l’anatomie décrite plus haut : noms explicites, descriptions qui disent aussi quand ne pas appeler, paramètres contraints, erreurs parlantes. La mise en pratique est détaillée sur Connecter une IA à un site internet.
Étape 5 : poser les droits et le périmètre
L’agent doit disposer de son propre compte, distinct de celui d’une personne, avec le rôle le plus restreint qui permette la tâche. Cette séparation a deux vertus : elle rend ses actions identifiables dans les journaux, et elle permet de lui retirer ses droits sans affecter personne.
Le périmètre se définit aussi par ce qui n’est pas accessible : quelles rubriques, quels types de contenus, quels champs restent hors de portée. Écrivez cette liste négative, elle est plus facile à contrôler que la liste positive.
Étape 6 : définir le critère de fin et le format de rendu
Un bon critère de fin est vérifiable par quelqu’un d’autre que vous. « Chaque fiche du lot a donné lieu à un brouillon comportant un titre, une description et une catégorie » se contrôle. « Le catalogue est à jour » ne se contrôle pas.
Exigez aussi un compte rendu : ce que l’agent a fait, sur quoi, et ce qu’il n’a pas pu traiter. Un agent qui termine en silence oblige à vérifier son travail dans son intégralité, ce qui annule le bénéfice.
Étape 7 : prévoir la reprise et l’annulation
Trois questions se tranchent avant la première exécution en écriture. Que se passe-t-il si l’agent s’interrompt au milieu d’un lot ? Comment annuler ce qu’il vient de faire ? Comment éviter qu’il refasse deux fois la même action si on le relance ?
Les réponses tiennent à des mécanismes classiques : marquer chaque élément traité, s’appuyer sur les révisions du CMS, travailler par lots bornés plutôt que sur la totalité d’un catalogue, et disposer d’une sauvegarde antérieure à l’exécution.
Étape 8 : journaliser
Conservez, pour chaque exécution, l’objectif reçu, la suite des outils appelés avec leurs paramètres, les résultats obtenus et la sortie finale. Sans cette trace, une action inattendue reste inexplicable et la confiance ne se reconstruit pas.
La journalisation sert aussi à maîtriser la dépense : c’est elle qui montre les tâches où l’agent tourne en rond, et celles où un workflow ferait le même travail pour moins cher.
Étape 9 : tester sur les cas tordus
Constituez un jeu de cas qui comprend l’ordinaire, mais surtout l’exceptionnel : la fiche incomplète, le fichier au mauvais format, la donnée contradictoire, l’élément déjà traité, le contenu dans une langue inattendue. Ajoutez un cas où l’agent devrait renoncer et le signaler.
Ce jeu se rejoue après chaque modification des instructions, des outils ou du modèle. Il est à l’agent ce que les tests sont à un logiciel, avec une différence : le résultat n’étant pas identique d’une exécution à l’autre, c’est la conformité au critère qui se juge, pas l’égalité des sorties.
Étape 10 : exploiter et surveiller la dérive
Un agent en production se surveille comme un service. Trois choses évoluent sans prévenir : le modèle utilisé, que le fournisseur fait évoluer ; vos contenus, dont la structure change ; et les usages, l’équipe finissant par confier à l’agent des cas non prévus.
Une revue périodique suffit à tenir l’ensemble : relire un échantillon d’exécutions, ajouter au jeu de cas ce qui a mal tourné, vérifier la dépense au regard du volume traité, et confirmer que le périmètre des droits est toujours celui décidé au départ.
Sécurité : avant d’ouvrir les écritures
Un agent qui écrit sur un site public mélange deux surfaces de risque : celle d’un compte à privilèges, et celle d’un système qui prend des décisions à partir de texte. Quatre points se traitent avant l’ouverture.
L’injection de consignes. Un agent qui lit un contenu peut y trouver du texte rédigé pour lui, glissé dans un commentaire, un formulaire ou un document importé, et destiné à le faire sortir de son rôle. On ne l’élimine pas, on la contient par la conception : tout texte lu doit être traité comme une donnée et non comme une instruction, aucune action engageante ne doit se déclencher sur la foi d’un contenu rencontré, et le périmètre des outils reste étroit.
Le cloisonnement des données. Un agent atteint ce que son compte peut atteindre. Sur un site où des contenus privés coexistent avec des contenus publics, la question « que voit ce compte » devient une question de sécurité opérationnelle, et elle se vérifie plutôt que de se supposer.
Les limites d’exécution. Nombre maximal d’itérations par tâche, nombre d’éléments traités par lot, plafond de dépense assorti d’une alerte. Ces trois bornes se posent le jour de la mise en service, pas après le premier incident.
La réversibilité. Avant la première exécution en écriture, assurez-vous qu’une sauvegarde antérieure existe, que les révisions du CMS sont actives, et que la suppression définitive ne figure dans aucun outil exposé.
Mesurer : les indicateurs qui disent la vérité
Le nombre de tâches traitées ne dit rien de la valeur produite. Quatre indicateurs disent quelque chose, et ils se relèvent sur vos propres exécutions plutôt que dans un comparatif.
- La part de sorties acceptées sans retouche. C’est l’indicateur central : il mesure ce que vous économisez réellement, retouches déduites.
- La fréquence des retours arrière. Elle indique si le palier de délégation actuel est tenable ou s’il faut revenir en arrière.
- Le nombre d’itérations par tâche. Une dérive à la hausse signale des outils mal décrits ou un objectif trop vague, et se traduit directement sur la facture.
- La part de cas signalés plutôt que traités. Un agent qui ne renonce jamais est un agent qui n’a pas appris à renoncer, ce qui est un défaut et non une performance.
Relevez une valeur de départ avant la mise en service. Sans point de comparaison, toute évolution ultérieure reste ininterprétable.
Quand l’agent n’est pas la réponse
Quatre situations doivent orienter vers autre chose.
- La procédure est stable et entièrement descriptible. Un workflow coûte généralement moins cher, tourne plus vite et se diagnostique plus facilement.
- La tâche ne comporte aucune compréhension de texte libre. Déplacer des fichiers, synchroniser deux bases, envoyer une notification : un traitement classique ou des webhooks suffisent.
- Le résultat doit être identique à chaque exécution. Un calcul, une facture, une règle réglementaire ne tolèrent pas la variation inhérente à un modèle.
- Le besoin est en réalité un outil métier. Quand l’interface, les droits et le suivi comptent autant que le traitement, c’est une application métier qu’il faut construire.
Erreurs fréquentes
- Confier une tâche qu’on n’a jamais écrite. Ce qu’on ne sait pas expliquer à un nouveau collaborateur ne se délègue pas à un agent.
- Utiliser le compte d’un administrateur. Les actions deviennent indistinguables des siennes et le retrait des droits impossible sans le pénaliser.
- Exposer des outils trop fins. Une multitude d’opérations techniques oblige l’agent à reconstituer la logique métier, ce qu’il fait mal et cher.
- Sauter le palier brouillon. Passer directement à l’écriture prive de la seule période où l’on peut observer sans risque.
- Traiter tout un catalogue d’un coup. Le lot borné limite les dégâts et rend la vérification praticable.
- Oublier de mesurer le coût par tâche. Un agent qui itère beaucoup peut coûter plus que le temps humain qu’il remplace.
- Considérer un succès de démonstration comme une validation. Le non-déterminisme interdit de conclure sur une exécution réussie.
Liste de contrôle avant la première écriture
- La tâche tient en une phrase avec un déclencheur, un verbe et un objet.
- La procédure est écrite, cas particuliers compris.
- L’agent dispose d’un compte dédié, avec le rôle le plus restreint possible.
- La liste de ce qui reste hors de sa portée est écrite.
- Aucun outil exposé ne permet une suppression définitive.
- Le critère de fin est écrit et vérifiable par un tiers.
- Un compte rendu d’exécution est produit à chaque passage.
- Les appels d’outils sont journalisés avec leurs paramètres.
- Une limite d’itérations et un plafond de dépense sont en place.
- Le traitement se fait par lots bornés, avec marquage des éléments traités.
- Une sauvegarde antérieure à l’exécution existe et a été testée.
- Le jeu de cas comprend au moins une situation où l’agent doit renoncer.
Questions fréquentes
Un agent peut-il travailler sur mon site sans accès administrateur ?
Oui, et c’est la configuration recommandée. Un compte dédié doté du rôle minimal suffit à de nombreuses tâches éditoriales. Le rôle administrateur n’apporte rien à la tâche et retire la possibilité d’identifier les actions de l’agent dans les journaux.
Faut-il développer un serveur MCP pour commencer ?
Pas nécessairement. Si vos outils exposent déjà des interfaces documentées, un premier palier en lecture seule peut s’appuyer dessus. Le serveur MCP devient intéressant quand plusieurs assistants doivent atteindre le même système, ou quand vous voulez présenter des actions métier plutôt que des opérations techniques.
Comment savoir si mon besoin relève d’un agent ou d’un workflow ?
Dessinez la procédure. Si toutes les branches sont connues et que les conditions s’expriment par des règles, c’est un workflow. Si une branche dépend de ce que le système découvrira en cours de route, l’agent se justifie. En cas de doute, commencez par le workflow : il est plus simple de constater qu’il ne suffit pas que de réduire un agent devenu incontrôlable.
Que se passe-t-il si l’agent fait une erreur en production ?
Cela dépend entièrement de ce qui a été prévu avant. Avec des révisions actives, un lot borné, une sauvegarde antérieure et une journalisation complète, l’incident peut se corriger et s’analyser. Sans ces éléments, il devient une enquête. C’est la raison pour laquelle l’étape 7 précède la première exécution en écriture.
Un agent peut-il piloter plusieurs outils à la fois ?
Oui, et c’est souvent là qu’il devient utile : consulter un catalogue, vérifier une donnée dans un logiciel de gestion, puis créer un contenu sur le site. Chaque système expose ses propres actions, avec ses propres droits. La combinaison est traitée sur Connecter ChatGPT ou Claude à vos outils métier.
Combien coûte le fonctionnement d’un agent ?
La dépense dépend du nombre d’appels au modèle et de la quantité de contexte transmise à chacun, deux paramètres que la conception influence directement. Un agent qui itère peu parce que ses outils sont bien décrits coûte moins qu’un agent qui tâtonne. Les postes de budget d’un projet sont détaillés sur la page Tarifs, et le fonctionnement de la facturation à l’usage sur API IA.
Mes équipes doivent-elles être formées ?
Cela dépend de qui conçoit et de qui exploite. Le parcours complet figure sur Formations IA. La conception d’un agent, la définition de son périmètre et l’écriture des garde-fous font l’objet de la formation agents IA. La construction d’un serveur relève de la formation MCP. Pour les profils opérationnels qui pilotent des enchaînements sans développer, la formation automatisation IA est plus adaptée.
Un test à faire aujourd’hui
Demandez à la personne qui gère votre site de lister les gestes qu’elle répète chaque semaine sans y prendre le moindre intérêt. Pour chacun, posez trois questions : le geste tient-il en une phrase avec un déclencheur, existe-t-il déjà un moyen technique de l’exécuter autrement que par un clic, et une erreur se rattraperait-elle ?
Les gestes qui répondent oui trois fois sont vos candidats. S’il n’y en a aucun, le chantier à lancer n’est pas un agent : c’est l’exposition de vos outils, sans laquelle il n’y a rien à automatiser. Ce travail sert ensuite à tout le reste.
Pour aller plus loin
- Agents IA et MCP : le dossier complet, du fonctionnement d’un agent à la conception d’un serveur.
- Automatisation : la voie à examiner en premier, notamment pour WordPress.
- Comment intégrer l’IA à un site web en 2026 : le panorama des briques visibles par le visiteur.
- Développement IA : méthode de projet, couche applicative et coûts d’exploitation.
- IA pour le Web et Génération de contenu par IA : ce que l’agent produit côté éditorial, ainsi que Intégrer l’IA à un site web et IA et WordPress.
- SEO et GEO : ce qu’un agent peut contrôler côté visibilité, et ce qu’il ne faut pas lui laisser réécrire seul.
- Les autres publications du blog, et la page d’accueil pour situer la démarche du site.
- MCP : connecter ChatGPT et Claude à WordPress : pour voir concrètement l’acte de brancher un assistant sur les outils dont l’agent aura besoin.
- 20 tâches qu’un webmaster peut automatiser : pour piocher la première tâche nommable à confier, au lieu de la chercher à vide.
- Créer un agent IA pour son entreprise : pour transposer les quatre paliers de droits à un périmètre d’entreprise, outillage et budget compris.
- Chatbot IA pour entreprise : pour trancher les cas où le besoin réel ne modifie rien et relève d’un dispositif qui répond.
Vous avez une tâche en tête et vous voulez savoir si elle relève d’un agent, d’un workflow ou d’autre chose ? Décrivez-la et vous recevrez une réponse écrite. Si le projet est déjà cadré, la demande de devis mène directement au chiffrage.