
RAG : comment connecter une IA aux données de votre entreprise ?
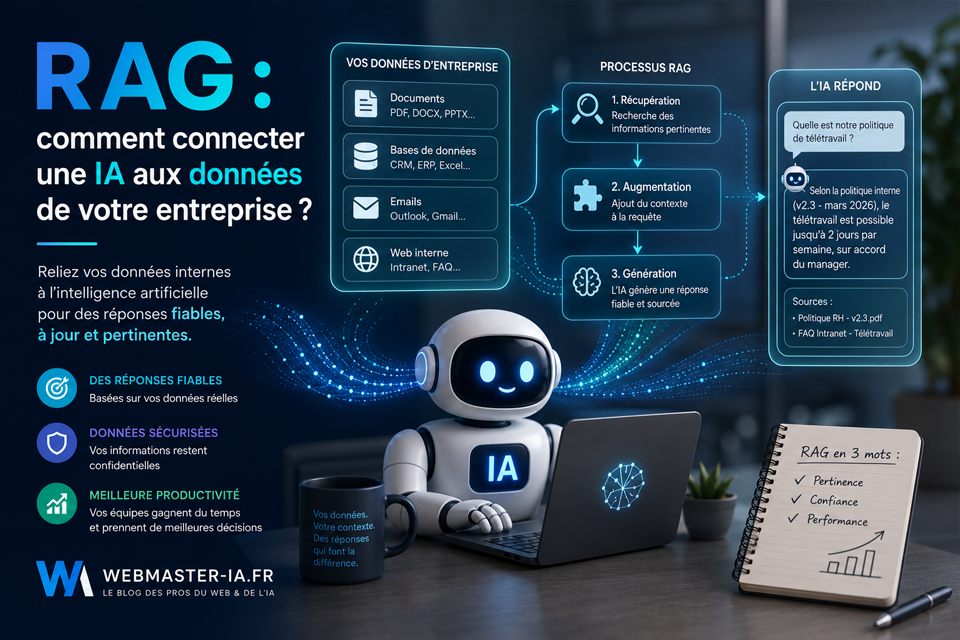
Un LLM ne connaît ni vos procédures internes, ni vos contrats, ni vos comptes rendus de réunion, ni votre documentation technique. Le RAG sert exactement à combler ce vide : aller chercher les bons extraits dans vos propres documents, puis les remettre au modèle au moment précis où il rédige sa réponse.
Le sigle RAG signifie Retrieval Augmented Generation, soit la génération augmentée par la récupération. L’idée est simple : au lieu d’espérer qu’un modèle sache quelque chose, on lui fournit la matière au moment de la question. Toute la difficulté tient dans ce mot discret, récupération. Un projet de RAG échoue rarement à cause du modèle de langage : il échoue parce que le système n’a pas retrouvé le bon passage, l’a retrouvé amputé de son contexte, ou l’a retrouvé alors que l’utilisateur n’avait pas le droit de le lire.
Ce que couvre ce guide
Ce guide suit la chaîne technique dans l’ordre où on la construit, du fichier posé sur un serveur jusqu’à la réponse citée et vérifiable. Il s’adresse à une organisation dont les documents internes sont dispersés et qui veut qu’une IA réponde à partir d’eux.
- L’inventaire des sources, l’ingestion, le découpage en fragments et les métadonnées.
- Les embeddings, le stockage vectoriel et les trois familles de recherche.
- Le reclassement des résultats, la construction du contexte et la citation des sources.
- Les droits d’accès par utilisateur, l’évaluation séparée, la fraîcheur et la gouvernance.
Plusieurs sujets relèvent d’autres pages. La recherche destinée aux visiteurs d’un site public est traitée dans la recherche intelligente, l’assistant conversationnel ouvert au public dans le chatbot IA. Le protocole MCP, les agents et les droits d’écriture relèvent de la rubrique agents et MCP, et le cas particulier d’un CMS d’IA et WordPress.
Ce que le RAG résout, et ce qu’il ne résout pas
Le RAG résout un problème de mémoire et un problème de vérifiabilité. Un modèle généraliste, entraîné sur un corpus public arrêté à une date donnée, ignore votre grille tarifaire interne, votre procédure de retour marchandise et la clause négociée avec tel client. En branchant une base de connaissances IA sur le modèle, vous lui donnez cette matière sans le réentraîner, et la réponse arrive accompagnée des documents qui l’ont produite.
Il résout aussi un problème d’échelle humaine. Retrouver une information dispersée entre un serveur de fichiers, une messagerie, un espace collaboratif et un CRM suppose de savoir où chercher. Un système de récupération fait ce travail de localisation, puis résume ce qu’il a trouvé.
En revanche, il ne résout pas quatre choses. Le RAG ne supprime pas les réponses inventées : il les limite, parce que le modèle a sous les yeux un texte de référence plutôt que sa seule mémoire, mais il reste capable d’affirmer une chose fausse à partir d’un extrait ambigu. Il ne répare pas des documents contradictoires ou périmés : si deux procédures se contredisent, le système restituera la contradiction. Il ne remplace pas un raisonnement métier qui suppose de croiser des règles et de trancher, besoin qui relève d’une application métier IA. Enfin, il ne fabrique pas une politique de confidentialité : il hérite des droits que vous lui donnez, ni plus ni moins.
RAG ou réglage fin d’un modèle : deux réponses à deux problèmes
Faut-il récupérer des documents, ou entraîner le modèle sur ses données ? Les deux approches ne visent pas la même chose. Le réglage fin, ou fine tuning, modifie le comportement du modèle : son style, son format de sortie, sa façon de classer. La récupération lui apporte des faits qu’il ne possède pas. Vouloir enseigner des faits par le réglage fin produit un modèle qui parle du bon sujet sans pouvoir citer sa source, et qu’il faut réentraîner à chaque modification d’un document.
| Critère | RAG | Réglage fin d’un modèle |
|---|---|---|
| Objectif visé | Apporter des faits internes au moment de la question | Modifier le style, le format ou le comportement de sortie |
| Nature de la connaissance | Documentaire, mouvante, datée | Structurelle, stable, transversale |
| Mise à jour d’une information | On remplace le document et on réindexe | On relance un cycle d’entraînement |
| Traçabilité de la réponse | Les extraits sources peuvent être affichés | Aucune source restituable |
| Droits d’accès par utilisateur | Filtrables au moment de la recherche | Impossibles à cloisonner après coup |
| Effort de maintenance | Porte sur les données et l’indexation | Porte sur les jeux d’entraînement |
| Cas typique | Répondre sur une procédure interne | Imposer un format de réponse constant |
Les deux se combinent parfois : le réglage fin discipline la forme, la récupération alimente le fond. Mais commencer par la récupération est presque toujours le bon ordre, car c’est l’étape qui révèle l’état réel de vos données, premier point à regarder dans un projet d’intégration LLM.
La chaîne complète, vue d’ensemble
Gardez en tête le trajet complet, parce que chaque incident observé côté réponse se rattache à un maillon précis. La chaîne se lit en deux temps : une phase hors ligne qui prépare le corpus, une phase en ligne qui se déclenche à chaque question.
- Phase de préparation : sources identifiées, puis ingestion et conversion en texte, puis découpage en fragments, puis attribution des métadonnées, puis calcul des embeddings, puis écriture dans un index consultable.
- Phase d’interrogation : question reçue, puis reformulation éventuelle, puis recherche filtrée par les droits de l’utilisateur, puis reclassement des candidats, puis assemblage du contexte, puis génération de la réponse avec citation, puis journalisation.
Retenez la règle de lecture qui va servir dans tout l’article : si la réponse est mauvaise, demandez d’abord si le bon passage figurait dans le contexte transmis au modèle. Sinon, le problème est en amont, dans la préparation ou la recherche. S’il y figurait, alors seulement la génération est en cause.
Étape par étape, un maillon après l’autre
Inventorier les sources avant de brancher quoi que ce soit
Le premier livrable d’un projet de RAG n’est pas du code, c’est un tableau des sources : où se trouve chaque gisement de documents, qui en est propriétaire, quel volume il représente, à quel rythme il bouge, quels formats il contient, qui a le droit de le lire. Cet inventaire révèle presque toujours des doublons de versions, des documents que plus personne ne maintient, et des sources dont l’accès reste à créer via une API. C’est aussi le moment de trancher le périmètre : un corpus restreint et propre répond mieux qu’un corpus exhaustif et sale, car chaque document inutile devient un concurrent à la recherche.
Ingestion et conversion : transformer des fichiers en texte exploitable
Un document bureautique, une présentation, un PDF issu d’un scan et une page d’espace collaboratif ne se lisent pas de la même façon. L’ingestion extrait un texte propre en préservant ce qui porte du sens : hiérarchie des titres, ordre de lecture, tableaux, légendes. C’est le maillon le plus ingrat et celui qui détermine tout le reste, car un tableau aplati en suite de mots deviendra un fragment illisible. Deux décisions doivent être explicites : que fait-on des documents scannés, dont la reconnaissance optique donne un texte parfois approximatif, et des images porteuses d’information, qui appellent une description textuelle ou une exclusion assumée. Cette phase se pilote depuis des workflows automatisés.
Découper en fragments : le chunking
On ne cherche pas dans des documents entiers, on cherche dans des fragments. Le principe à retenir est un équilibre, pas une valeur : un fragment trop court perd son contexte et devient inexploitable, puisque la phrase récupérée ne dit plus de quoi elle parle ; un fragment trop long mélange plusieurs idées et rend la comparaison de similarité moins discriminante. La bonne pratique consiste à découper selon la structure du document : une section, une clause contractuelle, une entrée de procédure. On ajoute un léger chevauchement entre fragments voisins pour ne pas couper une idée en deux, et l’on préfixe chaque fragment du fil d’Ariane de ses titres parents. Un fragment doit pouvoir être lu seul, sans le document sous les yeux.
Attacher des métadonnées : le maillon que tout le monde escamote
Chaque fragment doit transporter des informations sur lui-même : document d’origine, titre, section, date de publication, date de dernière révision, service responsable, langue, statut de validité, et surtout niveau de confidentialité ou liste des groupes autorisés. Sans ces champs, vous ne pourrez ni filtrer par droits, ni préférer la version récente à la version périmée, ni citer la source, ni retirer proprement un document. C’est l’un des maillons les moins spectaculaires et des plus rentables : filtrage par utilisateur, gestion de la fraîcheur et citation vérifiable en dépendent entièrement. Les ajouter après coup coûte bien plus cher que de les prévoir dès l’ingestion.
Calculer les embeddings : convertir le sens en coordonnées
Un embedding est une représentation numérique d’un texte, construite de telle sorte que deux textes de sens proche se retrouvent proches dans cet espace. C’est ce qui permet de retrouver un passage sur la « rupture anticipée du contrat » quand la question évoque « arrêter un abonnement en cours », alors qu’aucun mot n’est commun. Trois règles suffisent. La question et les fragments doivent être encodés par le même modèle d’embedding, sans quoi la comparaison n’a pas de sens. Changer de modèle oblige à recalculer tout le corpus, opération de maintenance à anticiper. Enfin la langue compte : un corpus multilingue pose la question de savoir si une question française doit remonter un document anglais.
Stocker les vecteurs
Le stockage conserve chaque fragment, son embedding et ses métadonnées, et sait répondre à la question « quels fragments ressemblent le plus à ce vecteur, parmi ceux qui respectent ces filtres ». Cette capacité à combiner similarité et filtrage est un critère de choix décisif, bien avant la performance brute.
Rechercher
La recherche part de la question, éventuellement reformulée, et remonte un ensemble de fragments candidats. Deux traitements sont utiles en amont. La reformulation réécrit une question elliptique en question autonome, indispensable quand l’utilisateur écrit « et pour les clients belges ? ». La décomposition sépare une question qui en contient plusieurs, pour lancer plusieurs recherches distinctes plutôt qu’une recherche moyenne.
Reclasser les candidats
La recherche privilégie la vitesse sur un grand volume et rapporte donc une liste large et imparfaite. Le reclassement, ou reranking, reprend cette liste courte et la réordonne avec un modèle plus attentif, qui examine la question et chaque fragment ensemble plutôt que séparément.
Construire le contexte
Le contexte est le texte réellement transmis au modèle, et sa construction n’est pas une simple concaténation. Il faut supprimer les fragments quasi identiques, qui gaspillent la place sans rien apporter, conserver l’identifiant de source en tête de chaque extrait, ordonner les extraits de façon lisible et fixer une limite de volume cohérente avec la fenêtre de contexte du modèle. Une décision structurante se prend ici : que fait le système quand la recherche ne rapporte rien de pertinent ? La bonne réponse est de le dire, pas de générer quand même. Un système capable de répondre « je n’ai rien trouvé dans les documents auxquels vous avez accès » inspire plus confiance qu’un système qui répond toujours.
Générer la réponse et citer
Le prompt d’un système de RAG a une mission étroite : répondre à partir des extraits fournis, signaler ce qui n’y figure pas, rattacher chaque affirmation à sa source. Il précise aussi quoi faire en cas de contradiction entre deux extraits, cas fréquent quand deux versions d’une procédure coexistent.
Journaliser
Dernier maillon, souvent oublié au démarrage : conserver la trace de chaque interrogation, avec la question, les fragments récupérés, ceux retenus dans le contexte et la réponse produite. Sans ce journal, aucune évaluation sérieuse n’est possible.
Choisir un stockage vectoriel par catégorie, pas par produit
Le marché des bases vectorielles évolue vite et les comparatifs de produits vieillissent en quelques mois. Raisonner par catégorie reste valable plus longtemps, parce que ce sont les contraintes d’exploitation qui décident.
| Catégorie | Principe | Points d’attention | Contexte où c’est cohérent |
|---|---|---|---|
| Extension vectorielle greffée sur une base relationnelle | La recherche de similarité s’ajoute à une base déjà en production | Montée en charge à surveiller sur de très gros corpus | L’équipe exploite déjà cette base et veut un seul système à sauvegarder |
| Base vectorielle dédiée auto-hébergée | Composant spécialisé installé sur votre infrastructure | Un service de plus à administrer, sauvegarder et mettre à jour | Volume important et exigence de maîtrise complète de l’hébergement |
| Service vectoriel géré | L’infrastructure est opérée par un tiers, vous consommez une API | Localisation des données et dépendance à un fournisseur externe | Petite équipe technique, besoin de démarrer sans exploitation lourde |
| Moteur de recherche documentaire doté d’une capacité vectorielle | Recherche par mots et recherche vectorielle dans le même moteur | Configuration plus riche donc plus exigeante à régler | Recherche hybride souhaitée dès le départ, ou moteur déjà en place |
| Index en mémoire embarqué dans l’application | Bibliothèque chargée dans le processus applicatif | Persistance et reconstruction de l’index à gérer soi-même | Prototype, corpus restreint, validation d’un cas d’usage |
Quelle que soit la catégorie, posez quatre questions avant de vous engager : le filtrage par métadonnées s’applique-t-il pendant la recherche ou seulement après, ce qui change tout pour les droits d’accès ; comment met-on à jour ou supprime-t-on un fragment isolé ; que se passe-t-il le jour où il faut tout réindexer ; où les données sont-elles hébergées. Ces critères se discutent en cadrant le projet de développement IA.
Recherche vectorielle, recherche par mots, recherche hybride
La recherche vectorielle compare des sens. Elle excelle sur les questions formulées avec des mots différents de ceux du document, sur les synonymes et sur les tournures indirectes. Elle a une faiblesse constante : elle est mauvaise sur les chaînes exactes. Une référence de produit, un numéro de contrat ou un acronyme maison ne se distinguent pas bien dans un espace de similarité sémantique, parce qu’ils portent peu de sens. La recherche par mots-clés, dite lexicale, fait exactement l’inverse : elle retrouve à coup sûr une référence exacte, mais reste aveugle à la reformulation. Chacune couvre l’angle mort de l’autre.
La recherche hybride exécute les deux et fusionne les résultats. C’est le réglage par défaut à recommander en entreprise, parce que les corpus internes sont saturés de références, de codes et de sigles propres à la maison. La fusion peut se faire par combinaison des scores ou par combinaison des rangs, cette dernière étant plus robuste car elle évite de comparer deux échelles qui n’ont pas la même nature.
Un quatrième levier complète l’ensemble : le filtrage préalable par métadonnées. Restreindre la recherche à un service, à un type de document ou à une période avant de comparer les similarités améliore souvent plus la pertinence qu’un changement de modèle d’embedding. Les mêmes principes se retrouvent dans un projet de site web enrichi par l’IA.
Le reclassement : trier ce que la recherche a rapporté
La recherche initiale doit être rapide sur tout le corpus, donc elle compare des représentations calculées séparément pour la question et pour chaque fragment. Cette économie ignore les interactions fines entre les deux textes. Le reclassement corrige cela sur une liste courte de candidats, avec un modèle qui lit la question et le fragment ensemble et attribue un score de pertinence réelle.
L’effet pratique est net : les fragments seulement proches par le thème redescendent, ceux qui répondent effectivement remontent. Comme le modèle ne verra qu’un nombre limité d’extraits, l’ordre compte énormément. Deux contreparties : le reclassement ajoute du calcul donc de la latence, à mesurer sur des questions réelles ; et il ne répare pas une récupération manquée, puisqu’un fragment jamais remonté ne peut pas être trié. Reclasser sert à ordonner, pas à retrouver.
Citer les sources : ce qui rend le système vérifiable
La citation transforme un assistant que l’on croit sur parole en un outil que l’on peut contrôler. Chaque extrait porte un identifiant, le prompt demande de rattacher les affirmations à ces identifiants, et l’interface transforme ces marqueurs en liens vers le document d’origine.
Quelques exigences la rendent réellement utile. Elle doit pointer vers le document tel qu’il existe dans son système d’origine, pas vers une copie figée dans l’index, sinon l’utilisateur consulte une version périmée. Elle doit afficher la date de la version citée, ce qui suppose la métadonnée correspondante. Elle doit permettre de voir le passage exact retenu, pas seulement le nom du fichier. Et il faut valider automatiquement que les identifiants cités existent dans le contexte transmis, car un modèle peut inventer une référence. Effet indirect : un système qui cite ses sources est un système que les utilisateurs corrigent.
Les droits d’accès par utilisateur : un même corpus, des réponses différentes
Voici le sujet que les articles génériques traitent en une phrase, et qui décide pourtant si le système est déployable au-delà d’une petite équipe. Dans une entreprise, tout le monde n’a pas le droit de lire la même chose : grilles de rémunération, dossiers du personnel, contrats clients, documents juridiques en cours, projets confidentiels. Un système de RAG qui ignore cette réalité fabrique une fuite d’information, d’autant plus dangereuse qu’elle est confortable : l’assistant répond bien, à tout le monde, sur tout.
Le principe tient en une règle : la recherche doit être effectuée dans le périmètre de l’utilisateur qui pose la question, et non filtrée après coup. Filtrer ensuite ne suffit pas : le fragment interdit a déjà transité par le système et peut apparaître dans les journaux ou les caches, et le nombre de résultats retournés devient variable selon les personnes, ce qui dégrade silencieusement la qualité pour ceux qui ont le moins de droits.
La mise en oeuvre suit une logique constante. Chaque fragment hérite, à l’ingestion, des autorisations du document dont il provient : groupes, service, niveau de confidentialité. À la question, l’identité de l’utilisateur est résolue en une liste de groupes qui devient un filtre appliqué pendant la recherche. Le point de vigilance est le décalage temporel : quand quelqu’un change de service ou quitte l’entreprise, l’index doit suivre. Un cycle de synchronisation des autorisations est aussi important que celui des contenus.
- Décidez du comportement par défaut : un document sans autorisation identifiée doit être exclu, jamais rendu accessible à tous.
- Journalisez qui a interrogé quoi et quels documents ont été restitués, en protégeant ce journal lui-même.
- Prévoyez le retrait d’urgence d’un document, procédure distincte de la mise à jour ordinaire.
- Testez explicitement le cloisonnement : une même question posée par deux profils doit produire deux réponses différentes.
Ce dernier test est le plus parlant en démonstration interne : il révèle immédiatement les failles de configuration. Quand la connexion aux outils métier passe par des connecteurs applicatifs, vérifiez que l’identité de l’utilisateur est propagée jusqu’au système source, et non remplacée par un compte de service unique qui verrait tout.
Évaluer la récupération et la génération séparément
C’est la distinction la plus utile du sujet, et celle qui manque le plus souvent. Tant que l’on juge « la réponse » comme un tout, on corrige au hasard : on retouche le prompt alors que le problème vient du découpage, on change de modèle alors que le document n’était pas dans l’index.
L’évaluation de la récupération répond à une seule question : le passage qui contient la réponse figurait-il dans les extraits transmis au modèle ? Elle se construit avec un jeu de questions réelles, pour lesquelles on a identifié à la main les passages attendus, et l’on mesure si ces passages sont retrouvés et à quel rang. L’évaluation de la génération ne s’exécute que sur les cas où la récupération a réussi : la réponse est-elle fidèle aux extraits, les citations correspondent-elles au contenu invoqué, le système reconnaît-il son ignorance quand la matière est absente ? Ce dernier point mérite un jeu de tests dédié, avec des questions volontairement hors corpus.
| Symptôme observé | Cause probable | Où corriger |
|---|---|---|
| La réponse invente alors que le document existe bel et bien | Le bon fragment n’a jamais atteint le contexte | Récupération : découpage, embeddings, recherche hybride, reclassement |
| La réponse est plausible mais contredit un extrait fourni | Le modèle s’écarte de la matière transmise | Génération : consignes du prompt et contrôle de fidélité |
| Le système ne trouve jamais les références et codes internes | Recherche purement sémantique, aveugle aux chaînes exactes | Récupération : ajouter la recherche lexicale et fusionner |
| Les extraits parlent du bon thème sans répondre à la question | Similarité thématique confondue avec pertinence | Récupération : introduire ou régler le reclassement |
| Les réponses citent une procédure abandonnée | Anciennes versions toujours présentes dans l’index | Gouvernance : suppression, métadonnée de validité, préférence de fraîcheur |
| La réponse est correcte mais amputée d’une partie | Fragments trop courts ou coupés au milieu d’une idée | Préparation : stratégie de découpage et chevauchement |
| Un utilisateur voit une information qu’il ne devrait pas voir | Filtrage appliqué après la recherche, ou droits non synchronisés | Droits : filtrage pendant la recherche et cycle de synchronisation |
| La qualité chute dès la deuxième question d’une conversation | Question elliptique envoyée telle quelle à la recherche | Récupération : reformulation autonome de la question |
| Les citations pointent vers des sources inexistantes | Identifiants produits par le modèle sans contrôle | Génération : validation des identifiants contre le contexte |
| Les tableaux et annexes ne remontent jamais | Structure perdue à la conversion des fichiers | Préparation : ingestion et extraction structurée |
| Le système répond quand même alors qu’il n’a rien trouvé | Aucun seuil ni comportement de repli défini | Contexte : seuil de pertinence et réponse d’abstention |
Ce tableau se lit comme un arbre de décision : vous observez la colonne de gauche, vous en déduisez où porter l’effort, et vous évitez la dépense la plus fréquente, qui consiste à réécrire un prompt pour un problème situé dans le découpage.
Fraîcheur et gouvernance : qui met à jour quoi, et quand
Un corpus n’est pas un projet, c’est un actif vivant. Sans règle de mise à jour, un système de RAG se dégrade silencieusement : il continue de répondre avec assurance, à partir de documents périmés. Ce mode de défaillance est pernicieux parce que rien ne signale la panne.
Trois décisions structurent la gouvernance. Le mode de rafraîchissement d’abord : réindexation complète et périodique, simple mais coûteuse, ou mise à jour incrémentale déclenchée par les modifications, plus efficace mais qui suppose de savoir détecter changements et suppressions. La suppression ensuite, souvent oubliée : quand un document disparaît de la source, ses fragments doivent disparaître de l’index, faute de quoi vous conservez un fantôme qui continuera d’alimenter les réponses. La responsabilité enfin : chaque famille de documents doit avoir un propriétaire nommé, qui décide de ce qui est valide.
| Famille de sources | Rythme de mise à jour cohérent | Propriétaire à désigner | Signal de péremption à surveiller |
|---|---|---|---|
| Procédures et politiques internes | Sur événement, à chaque validation d’une nouvelle version | Service émetteur de la procédure | Date de révision dépassée sans nouvelle version |
| Documentation produit et technique | Aligné sur le cycle de publication des versions | Équipe produit ou technique | Version citée qui n’est plus commercialisée |
| Contrats et documents juridiques | Sur événement, à la signature ou à l’avenant | Direction juridique ou administrative | Échéance ou clause de reconduction atteinte |
| Base de réponses au support client | Récurrent et rapproché | Responsable du support | Réponses jamais consultées ou souvent corrigées |
| Comptes rendus et notes de réunion | Au fil de l’eau, avec archivage au-delà d’un horizon défini | Secrétariat ou pilote de projet | Décisions annulées par une réunion ultérieure |
Deux réflexes complètent ce cadre. Affichez la date de la version citée, afin que l’utilisateur juge lui-même de la fraîcheur. Et prévoyez, quand deux versions coexistent, que le système privilégie explicitement la plus récente et signale l’existence de l’autre plutôt que de choisir en silence. Le déclenchement se met en place avec des webhooks ou des tâches planifiées, selon les systèmes sources.
Coûts d’exploitation : où part réellement l’argent
Sans avancer de montants, qui dépendent des fournisseurs et des volumes, il est utile de savoir quels postes existent. Le calcul des embeddings représente une dépense initiale importante puis marginale, sauf le jour où l’on change de modèle et où il faut tout recalculer. L’hébergement de l’index dépend du volume de fragments et de la catégorie retenue. La génération constitue le poste récurrent principal, proportionnel à la quantité de texte transmise : c’est ici que le reclassement devient un levier économique, puisqu’il permet d’envoyer moins d’extraits mieux choisis.
Deux postes sont systématiquement sous-estimés. D’abord l’ingestion continue : convertir, découper et réindexer en permanence a un coût de calcul et surtout d’exploitation humaine. Ensuite la maintenance du corpus, le temps passé par les propriétaires de documents à valider, corriger et retirer. Ce poste pèse lourdement sur la qualité, et il figure rarement dans une estimation d’infrastructure. Ces éléments se cadrent au chiffrage, avec la grille de tarifs ou une demande de devis.
Les erreurs fréquentes
- Tout indexer d’un coup. Déverser tous les serveurs de fichiers produit un corpus bruyant où les documents obsolètes concurrencent les valides.
- Traiter les métadonnées comme un détail. Sans elles, ni filtrage par droits, ni gestion de la fraîcheur, ni citation fiable.
- Se contenter de la recherche vectorielle. Les corpus internes sont pleins de références exactes que la sémantique seule ne retrouve pas.
- Découper mécaniquement. Couper au milieu d’un tableau ou d’une clause fabrique des fragments incompréhensibles.
- Ignorer les droits jusqu’à la mise en production. Rajouter le cloisonnement sur un index construit sans lui suppose souvent de tout reprendre.
- Ne pas gérer les suppressions. Un document retiré de la source mais resté dans l’index continue de produire des réponses.
- Corriger le prompt pour un problème de récupération. C’est l’erreur la plus coûteuse, et le tableau des symptômes existe pour l’éviter.
- Promettre la fin des réponses inventées. Le RAG les limite fortement, il ne les supprime pas, et annoncer l’inverse détruit la confiance au premier incident.
Questions fréquentes
Faut-il un très gros volume de documents pour que le RAG ait un intérêt ?
Non. L’intérêt vient de la dispersion des documents et de la fréquence des questions, pas du volume. Un ensemble modeste de procédures interrogées chaque semaine justifie la démarche, alors qu’une immense archive que personne ne consulte n’apporte rien. Un petit corpus est même plus facile à maintenir propre, et la propreté pèse plus lourd que la taille.
Le RAG élimine-t-il les réponses inventées ?
Il les limite nettement, il ne les élimine pas. Le modèle dispose d’un texte de référence, ce qui réduit sa tendance à combler les vides, mais il peut encore mal interpréter un extrait ambigu, extrapoler à partir d’une information partielle ou mélanger deux passages. C’est pourquoi la citation systématique, le contrôle de fidélité et la possibilité de répondre « je n’ai pas trouvé » font partie intégrante du dispositif.
Mes documents partent-ils chez un fournisseur externe ?
Cela dépend de l’architecture retenue, et c’est une décision à prendre consciemment. Trois points transitent potentiellement vers un tiers : le calcul des embeddings, l’hébergement de l’index et la génération de la réponse. Chacun peut être opéré en interne ou confié à un service, avec des conséquences différentes sur la localisation des données et la contractualisation. Tranchez-les séparément.
Peut-on brancher un RAG sur un CRM ou un outil métier plutôt que sur des fichiers ?
Oui, et c’est fréquent. La différence tient à la nature des données : un outil métier expose des enregistrements structurés, pas des documents. On les transforme en textes cohérents avant indexation, ou l’on interroge directement l’outil par son API pour les données qui doivent être exactes à l’instant présent. Un solde, un statut de commande ou un stock ne doivent jamais provenir d’un index recopié. Ce raccordement relève d’une connexion aux outils métier.
Comment savoir si le problème vient de la récupération ou du modèle ?
Regardez le contexte réellement transmis, ce que permet la journalisation. Si le passage nécessaire ne s’y trouvait pas, tout se joue en amont et modifier le prompt sera sans effet. S’il s’y trouvait et que la réponse s’en écarte, le sujet est bien la génération. Cette vérification évite des corrections mal orientées.
Combien de temps faut-il pour obtenir une première version utilisable ?
Cela dépend surtout de l’état des documents, rarement de la technique. Quand les sources sont accessibles, propres et dotées d’autorisations claires, une première version circonscrite se construit vite. Quand il faut d’abord retrouver les documents valides, arbitrer entre des versions concurrentes et créer les accès techniques, l’essentiel du travail se situe avant la moindre ligne de code.
Un test à faire aujourd’hui
L’exercice qui suit ne demande aucun outil. Réunissez les questions que vos équipes posent réellement, celles qui arrivent par messagerie interne ou en réunion. Retenez-en une dizaine, en incluant volontairement une question dont la réponse est confidentielle et une question dont la réponse n’existe nulle part.
- Retrouvez à la main le document et le passage exact qui répond à chaque question, et notez le temps que cela vous prend.
- Notez si vous trouvez plusieurs versions contradictoires, et laquelle fait autorité.
- Notez qui, dans l’organisation, a le droit de lire chacun de ces documents.
- Pour la question confidentielle, vérifiez que l’autorisation est portée par le document et pas seulement par l’emplacement où il est rangé.
- Pour la question sans réponse, décidez de ce que le système devra dire.
Ce petit inventaire est exactement le jeu d’évaluation dont vous aurez besoin, et il vous dira si votre corpus est prêt. Si vous ne trouvez pas les passages vous-même, aucun système de récupération ne le fera à votre place.
Pour aller plus loin
Le RAG constitue la couche de connaissance sur laquelle s’appuient ensuite d’autres briques : un assistant interne, un outil d’aide à la rédaction, ou des agents IA capables d’enchaîner des actions.
- La page base de connaissances IA détaille la structuration du corpus.
- Côté raccordement aux systèmes existants, voyez le serveur MCP, MCP et CMS, ainsi que connecter une IA à un site internet.
- Pour l’usage quotidien, l’automatisation des tâches web et l’automatisation par l’IA montrent ce que la connaissance récupérée permet de déclencher.
- Côté contenu, la génération de contenu et l’optimisation pour les LLM traitent de la visibilité, sujet voisin mais distinct.
- Pour monter en compétence, les formations IA, notamment la formation aux agents IA et la formation MCP.
- Sur le blog, l’article MCP, connecter ChatGPT et Claude à vos outils métier, celui sur les agents IA appliqués aux tâches d’un site et quinze exemples d’automatisation en entreprise.
- Toujours sur le blog, le chatbot IA pour entreprise montre ce que devient ce corpus une fois ouvert aux questions des clients, prix compris.
- Et pour cadrer le projet qui exploitera cette couche de connaissance, créer un agent IA pour son entreprise.
Si vous voulez faire évaluer votre corpus et cadrer une première version, présentez-moi vos sources et vos questions types via la page contact. Le diagnostic porte d’abord sur les documents, ensuite sur la technique, et c’est presque toujours dans cet ordre que se gagnent les projets. Vous trouverez une vue d’ensemble des prestations sur la page d’accueil et dans la rubrique IA et Web.