
MCP : comment connecter ChatGPT et Claude à WordPress et à vos outils métier ?
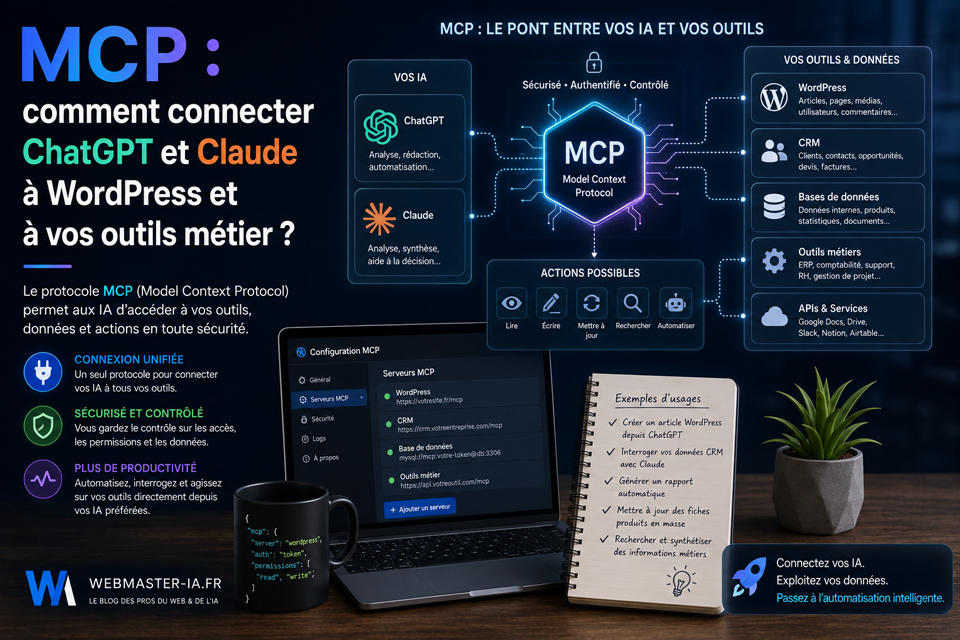
Vous avez déjà un assistant IA qui vous convient, et des systèmes qui tournent : un site WordPress, un CRM, un logiciel de facturation, une base documentaire. La question n’est plus de choisir un modèle, elle est de les relier proprement. MCP est le protocole qui normalise cette liaison. Ce guide explique comment on branche, ce qu’il faut préparer, ce qu’il faut refuser d’exposer, et quoi regarder quand rien ne répond.
Ce que couvre ce guide
Ce guide traite d’une seule chose : le branchement. Comment un assistant existant se connecte à des systèmes existants, avec quel protocole et quelles précautions. Il ne traite ni de la conception d’un agent, ni du choix entre agent et enchaînement automatisé, ni du découpage des droits par paliers : ces sujets sont développés dans l’article consacré aux agents IA et à l’automatisation des tâches d’un site web et sur la page agents IA.
Il ne reprend pas le panorama des briques visibles par le visiteur, traité dans l’article intégrer l’IA à un site web, ni l’installation générale d’une IA sur WordPress, couverte par le guide connecter une IA à WordPress : ici, on ne traite que la voie MCP. L’accès aux connaissances internes par recherche documentaire relève du RAG, sujet distinct et complémentaire.
Ce que MCP résout concrètement
MCP, pour Model Context Protocol, est un protocole ouvert publié par Anthropic. Sa raison d’être tient en une phrase : donner un format commun à la conversation entre une application qui héberge un LLM et un système qui détient des données ou des actions. Sans lui, chaque liaison est un développement particulier.
Le problème des N fois M connecteurs
Posez le problème en termes de combinatoire. D’un côté, les applications susceptibles d’appeler un LLM : un client de bureau, un environnement de développement, un outil interne. Appelons-les N. De l’autre, les systèmes à atteindre : le CMS, le CRM, la facturation, la base documentaire. Appelons-les M.
Sans protocole partagé, relier tout le monde à tout le monde revient à écrire N fois M intégrations. Chacune a sa gestion d’authentification, son format de description des actions, sa manière de renvoyer une erreur. Chacune doit être maintenue quand le système évolue, et réécrite quand vous changez d’assistant.
Le protocole déplace ce coût. Vous exposez une fois un serveur devant chaque système, et toute application hôte qui implémente le protocole côté client sait lui parler. On passe d’une matrice à deux listes : des serveurs, des clients. C’est la logique qui a rendu les API et les webhooks exploitables à grande échelle : le gain vient de la normalisation.
Le connecteur devient un actif
Un serveur exposé une fois est utilisable par les clients qui implémentent le protocole. Un connecteur écrit pour un assistant précis est une dépendance : il disparaît avec lui. Un serveur MCP est un actif : il décrit ce que votre système sait faire, dans un vocabulaire que d’autres applications lisent. Le travail se déplace vers le périmètre, les descriptions et les droits. Pour situer cette approche parmi les autres façons de connecter une IA à un site internet, la page dédiée pose le décor.
L’architecture en trois rôles
Une application hôte contient un client MCP, qui dialogue avec un serveur MCP. Trois responsabilités distinctes, et la confusion entre elles est à l’origine de la plupart des malentendus. L’hôte est le logiciel avec lequel l’utilisateur interagit et qui appelle le modèle. Le client est le composant embarqué qui parle le protocole. Le serveur est placé devant votre système.
| Rôle | Ce qu’il est | Ce qu’il fait | Ce que vous maîtrisez |
|---|---|---|---|
| Application hôte | Le logiciel utilisé par la personne | Sollicite le modèle, décide s’il faut appeler un outil, restitue le résultat | Le choix de l’outil et les autorisations accordées |
| Client MCP | Un composant interne à l’application hôte | Ouvre la connexion, découvre ce qui est exposé, transmet les appels et les réponses | Peu de chose : c’est l’éditeur de l’hôte qui l’implémente |
| Serveur MCP | Un programme placé devant votre système | Déclare ses primitives, vérifie les droits, exécute ou renvoie le contenu | Tout : périmètre, descriptions, authentification, journalisation |
Retenez la dernière colonne. Le serveur est la seule pièce que vous concevez entièrement, donc la seule sur laquelle agir pour restreindre, tracer ou corriger. Espérer contrôler un comportement depuis le prompt alors que le serveur autorise l’action revient à laisser une porte ouverte en demandant qu’on ne l’utilise pas. Un même hôte pouvant se connecter à plusieurs serveurs, vous exposez le CMS et l’outil de gestion séparément.
Les trois primitives : tools, resources, prompts
Un serveur MCP expose trois primitives : des tools (actions exécutables), des resources (contenus lisibles), des prompts (modèles d’instruction). Trois usages distincts, et une erreur classique qui consiste à tout faire passer par la première. Règle pour trancher : si l’utilisateur pouvait obtenir la même chose en ouvrant un fichier, c’est une resource ; s’il devait cliquer sur un bouton, c’est un tool ; s’il devait recopier une consigne d’un collègue, c’est un prompt.
Les tools : ce que le système sait faire
Un tool est une action que le serveur accepte d’exécuter : créer un brouillon, chercher une fiche client, mettre à jour un champ. Il est décrit par un nom, une description en langage naturel et des paramètres attendus. C’est cette description qui permet au modèle de savoir quand l’action est pertinente : un tool mal nommé sera ignoré, ou appelé au mauvais moment. C’est la seule primitive qui produit un effet, donc la seule qui exige une revue attentive.
Les resources : ce que le système donne à lire
Une resource est un contenu mis à disposition en lecture : un article, un fichier, une fiche, une page de documentation interne. Elle est identifiée et récupérable, sans effet de bord. C’est la primitive à privilégier quand le besoin est de donner du contexte, pas de déclencher. Un périmètre composé uniquement de resources reste en lecture seule : commencer par là est une méthode, pas une timidité.
Les prompts : des modèles d’instruction réutilisables
Un prompt, au sens du protocole, est un modèle d’instruction que le serveur propose. Il sert à formuler une demande récurrente de manière cohérente : préparer un compte rendu selon une trame, structurer une recherche. C’est la primitive la moins utilisée, souvent par oubli. Elle transporte pourtant le savoir-faire de qui connaît le système, ce qui manque aux équipes découvrant un environnement connecté en formation MCP.
| Primitive | Nature | Effet sur le système | À choisir quand |
|---|---|---|---|
| Tool | Action exécutable avec paramètres | Peut lire, écrire, déclencher | Le besoin est de faire : créer, modifier, rechercher, envoyer |
| Resource | Contenu identifié et lisible | Aucun : la lecture ne modifie rien | Le besoin est de donner du contexte : documents, fiches, références |
| Prompt | Modèle d’instruction proposé par le serveur | Aucun par lui-même | Une demande revient souvent et gagne à être formulée pareil par tous |
Les deux transports : stdio et HTTP
Le protocole prévoit deux transports. Le transport stdio correspond à un serveur local, lancé par l’application hôte, qui communique par les flux d’entrée et de sortie standard du processus. Le transport HTTP correspond à un serveur distant, joignable sur le réseau. Le choix détermine où vit le code, qui peut l’atteindre et quelle sécurité mettre autour.
stdio : le serveur vit sur la machine
L’hôte démarre le serveur comme un programme enfant et lui parle directement. Pas de port ouvert, pas d’URL, pas de certificat : les identifiants vivent dans la configuration locale ou dans des variables d’environnement. La surface d’exposition réseau est nulle, mais l’accès est limité à la machine qui lance le serveur. C’est le transport naturel pour un usage individuel, un premier essai, ou des fichiers locaux.
HTTP : le serveur est un service partagé
Le serveur est hébergé quelque part et plusieurs clients peuvent l’atteindre. C’est ce qu’il faut dès que plusieurs personnes utilisent la même connexion, dès que le système cible est distant, ou pour maîtriser les mises à jour depuis un point unique. La contrepartie : chiffrement, authentification, contrôle des appelants, supervision. Un serveur HTTP joignable sans authentification est une interface d’administration ouverte, quelles que soient les instructions données au modèle. Le raisonnement est celui de toute API exposée : la protection se conçoit au niveau du service, pas de l’appelant.
| Critère | stdio (serveur local) | HTTP (serveur distant) |
|---|---|---|
| Qui lance le serveur | L’application hôte, comme processus enfant | Un hébergement que vous administrez |
| Portée | La machine sur laquelle tourne l’hôte | Tous les clients autorisés à joindre l’URL |
| Surface réseau | Aucune exposition réseau propre au serveur | Un service accessible, à protéger comme tel |
| Authentification | Gérée localement, via la configuration du processus | Indispensable, avec contrôle des appelants |
| Mise à jour | Sur chaque poste concerné | En un point, pour tous les clients |
| Cas typique | Usage individuel, fichiers locaux, prototypage | Usage d’équipe, système distant, service mutualisé |
Une trajectoire raisonnable : commencer en stdio pour valider le périmètre, puis passer en HTTP quand le besoin devient collectif. Faire l’inverse revient à industrialiser une hypothèse.
Ce qu’il faut préparer avant de brancher
Le branchement est la partie la plus courte. Ce qui prend du temps, et détermine si le résultat sera utilisable, c’est la préparation. Quatre points la structurent.
L’inventaire des points d’entrée
Listez les systèmes concernés et, pour chacun, la façon de les atteindre légitimement : une API documentée, un accès base de données, un export, ou rien d’autre qu’une interface d’administration. Un système sans point d’entrée programmable ne devient pas accessible parce que vous placez un serveur devant : il faut d’abord lui construire une interface, projet décrit sur la page MCP et API.
Les usages réels, formulés par les utilisateurs
Demandez aux personnes concernées ce qu’elles veulent obtenir, sans parler d’outils : retrouver l’historique d’un client, préparer un brouillon à partir de notes, vérifier si une facture a été réglée. Ces phrases deviennent le cahier des charges. Un serveur construit à partir des capacités techniques plutôt que des usages expose beaucoup et sert peu.
Le compte technique et ses droits
Le serveur agira sous une identité dans le système cible. Créez un compte dédié, distinct des comptes humains, avec les droits strictement nécessaires. Un compte administrateur réutilisé parce que c’était plus rapide rend impossible toute distinction entre ce qu’a fait une personne et ce qu’a fait l’assistant.
L’environnement d’essai et le retour arrière
Prévoyez un endroit où une erreur ne coûte rien : une copie du site, un jeu de données de test, un espace documentaire séparé. Prévoyez aussi le retour arrière : révisions, sauvegardes, corbeille, journal des modifications. Ces mécanismes existent souvent déjà : vérifiez qu’ils couvrent ce que le serveur pourra toucher.
- Un environnement d’essai distinct de la production.
- Un mécanisme de retour arrière vérifié sur le périmètre concerné.
- Une journalisation côté serveur, décidée avant la mise en service et non après.
- Une règle claire sur les données que le serveur n’a pas le droit de restituer.
Cette préparation est celle de n’importe quel workflow automatisé : brancher un assistant, c’est ouvrir un canal d’exécution supplémentaire vers un système.
Connecter WordPress
WordPress est un cas favorable : il dispose d’une interface programmable, d’un système de rôles et de capacités déjà structuré, et d’un historique des modifications de contenu. Les trois éléments nécessaires à un branchement prudent sont présents nativement.
Où placer le serveur
Deux dispositions sont possibles. Le serveur vit avec le site, sous forme d’extension installée sur le même hébergement : il accède directement aux fonctions du CMS. Ou il vit à l’extérieur et dialogue par l’interface programmable du site : il devient un client de plus, soumis aux mêmes contrôles qu’un appel externe. Voir la page MCP pour WordPress, et la logique se transpose à d’autres systèmes de gestion de contenu, comme l’explique la page MCP et CMS.
Quoi exposer, dans quel ordre
Commencez par la lecture : contenus publiés, catégories, structure du site. Un assistant capable de lire votre site répond déjà à beaucoup de demandes : retrouver un article ancien, vérifier si un sujet a été traité, préparer un maillage interne cohérent. Ensuite seulement, ouvrez l’écriture par la porte la moins risquée : la création de brouillons, invisibles du public et supprimables. La génération de contenu assistée prend son sens à ce stade, une fois le canal fiabilisé.
| Étape | Ce que le serveur expose | Primitive adaptée | Point de vigilance |
|---|---|---|---|
| Lecture des contenus | Articles, pages, taxonomies, structure | Resources | Vérifier que rien de confidentiel n’entre dans le périmètre |
| Recherche interne | Recherche par mot-clé, date ou type de contenu | Tool en lecture | Limiter le volume renvoyé, sinon les réponses sont inexploitables |
| Création de brouillons | Nouvel article ou page à l’état de brouillon | Tool en écriture | Interdire la publication directe tant que la relecture n’est pas cadrée |
| Modification de contenus | Mise à jour d’un contenu existant | Tool en écriture | S’assurer que les révisions sont actives |
| Médias et métadonnées | Textes alternatifs, légendes, champs SEO | Tool en écriture | Restreindre aux champs concernés |
Les droits, côté WordPress
WordPress raisonne en capacités plutôt qu’en rôles, et le détail de ce découpage est traité dans le guide consacré à la connexion d’une IA à WordPress. Retenez ici le principe : le compte technique reçoit les seules capacités qui correspondent aux usages retenus, et rien de plus. Un rôle sur mesure vaut mieux qu’un rôle standard trop large.
Les droits ne dispensent pas du périmètre. Un compte peut avoir le droit de modifier tous les articles alors que le serveur ne devrait toucher qu’une catégorie : la restriction se code alors dans le serveur, en plus des droits du compte. La page IA et WordPress donne le panorama des autres voies, et la page automatisation WordPress couvre les tâches récurrentes qui s’appuient sur ce canal.
Si votre site est une boutique, le raisonnement est identique mais l’enjeu monte d’un cran : les objets manipulés sont des produits, des stocks et des commandes. Les précautions propres à ce contexte sont abordées sur la page automatisation e-commerce.
Connecter un outil métier
Passer du CMS aux outils de gestion change la nature du sujet. Un contenu mal rédigé se corrige. Une écriture erronée dans une comptabilité ou un dossier client engage l’entreprise. La méthode reste la même, mais la phase de lecture seule s’allonge.
Le CRM
Souvent le premier candidat, parce que la valeur est immédiate : retrouver l’historique d’un contact, préparer une relance, résumer un dossier. L’écriture doit être bornée : créer une note est une chose, modifier le statut d’une opportunité ou fusionner des fiches en est une autre. Attention aux doublons : un assistant qui crée une fiche faute d’avoir trouvé l’existante dégrade la base. Un tool de création doit imposer une recherche préalable. La page IA et CRM détaille ce que ce type de connexion permet et ce qu’elle exige.
L’ERP et la gestion commerciale
Un ERP manipule des objets liés : articles, tiers, commandes, stocks, projets. La difficulté n’est pas d’atteindre l’un d’eux, c’est de respecter les règles de cohérence qui les relient. Passez donc par l’interface programmable officielle, jamais par un accès direct à la base pour écrire. La lecture directe se discute, l’écriture directe se refuse : tranchez-le avant que quelqu’un ne prenne le raccourci. Les enjeux propres aux applications métier sont traités sur la page dédiée.
La comptabilité
Le domaine comptable a une particularité : certaines pièces, une fois validées, ne sont plus censées bouger. Exposer une action de modification sur ces objets créerait un problème de fond, indépendamment de la qualité de l’assistant. La position raisonnable : ouvrir la lecture largement, limiter l’écriture aux états provisoires, laisser la validation aux habilités. La lecture rend déjà de vrais services : retrouver une pièce, vérifier un état, préparer un récapitulatif.
La base documentaire et la GED
Une GED pose une question spécifique : les droits ne sont pas uniformes. Tel dossier est ouvert à tous, tel autre est réservé. Un serveur qui lit avec une identité unique aplatit cette structure et peut restituer un contenu qu’un utilisateur n’aurait pas dû voir. Deux réponses, à combiner : restreindre le périmètre aux espaces réellement partagés, ou faire vérifier par le serveur les droits de celui qui interroge. Si le besoin est de chercher dans un fonds documentaire, la question rejoint celle de la base de connaissances et du RAG, qui répond à un problème différent du branchement.
| Système | Ce que la lecture apporte | Ce que l’écriture doit rester | Point de vigilance propre |
|---|---|---|---|
| CRM | Historique d’un contact, contexte d’un dossier, relance | Notes, tâches, champs libres non structurants | Doublons si la recherche préalable n’est pas imposée |
| ERP et gestion commerciale | Articles, tiers, commandes, états de stock | Objets en brouillon, via les contrôles du logiciel | Cohérence entre objets liés, pas d’écriture directe en base |
| Comptabilité | Recherche de pièces, vérification d’un état, récapitulatifs | États provisoires, validation laissée aux habilités | Immuabilité des pièces validées |
| GED et base documentaire | Retrouver un document, en extraire l’essentiel | Dépôt dans un espace défini, sans reclassement | Droits hétérogènes selon les dossiers |
Dans tous les cas, la question préalable est la même : le système dispose-t-il d’une interface programmable exploitable ? Si oui, le serveur se construit devant elle. Sinon, il faut d’abord traiter ce manque. Voir la page connecter ChatGPT et Claude à vos outils métier.
Authentification, secrets et identités
Trois questions distinctes se cachent derrière un seul mot. Qui appelle le serveur ? Sous quelle identité agit-il dans le système cible ? Où vivent les identifiants ? Les traiter séparément évite la plupart des mauvaises surprises.
Qui appelle le serveur
En stdio, la réponse est donnée par le contexte : l’application hôte lancée par la personne connectée. En HTTP, elle doit être construite : le serveur doit vérifier l’appelant avant d’exécuter quoi que ce soit. Sans cette vérification, l’ensemble des tools devient accessible à qui connaît l’adresse. C’est la différence structurante entre les deux transports.
Sous quelle identité le serveur agit
Deux modèles coexistent. Le serveur agit sous une identité technique unique : simple, mais les droits sont uniformes et la traçabilité s’arrête au serveur. Ou il agit au nom de l’utilisateur qui a formulé la demande : les droits du système cible s’appliquent et la traçabilité est complète, mais il faut acheminer l’identité jusqu’au serveur. Le second devient nécessaire dès que les droits diffèrent d’une personne à l’autre. Ce que permettent vos outils se vérifie dans la documentation en vigueur, car cela évolue.
Où vivent les secrets
Les identifiants, clés et jetons appartiennent au serveur, jamais au prompt ni au contenu d’un échange. Un token collé dans une conversation circule, se retrouve dans des historiques et devient impossible à révoquer proprement. Le serveur les lit depuis sa configuration, ses variables d’environnement ou un gestionnaire de secrets, et ne les restitue jamais.
- Un compte technique distinct des comptes humains, pour distinguer les actions dans les journaux.
- Des droits alignés sur les usages retenus, pas sur le plus rapide à configurer.
- Des identifiants différents entre l’environnement d’essai et la production.
- Une procédure de révocation connue et testée, pas seulement documentée.
- Aucun secret dans les descriptions de tools, les messages d’erreur ou les contenus renvoyés.
- Un renouvellement des jetons planifié, plutôt que déclenché par un incident.
Ces règles ne sont pas propres à MCP : ce sont celles de toute intégration de LLM dans un système d’information. Elles méritent d’être rappelées parce que la facilité apparente du branchement pousse à les oublier.
Quand ça ne marche pas : la méthode de diagnostic
Le symptôme le plus courant est aussi le moins informatif : l’assistant répond qu’il ne peut pas faire ce qu’on lui demande. Cette phrase recouvre des causes très différentes. La seule méthode qui fonctionne consiste à remonter la chaîne dans l’ordre, sans sauter d’étape, parce que chaque étape suppose la précédente validée.
Étape 1 : le serveur démarre-t-il seul
Lancez le serveur hors de l’application hôte et regardez ce qu’il affiche. Un serveur qui ne démarre pas à cause d’une dépendance manquante, d’un chemin erroné ou d’une variable d’environnement absente ne donnera rien côté client. Cette étape élimine une bonne partie des situations bloquées.
Étape 2 : le client voit-il le serveur
Vérifiez que l’application hôte liste bien le serveur et ses primitives. Si la liste est vide alors que le serveur démarre, le problème est dans la connexion ou la déclaration. En stdio, regardez le chemin d’exécution et les variables transmises au processus. En HTTP, l’URL, le certificat, un éventuel proxy et le filtrage réseau.
Étape 3 : l’appel arrive-t-il jusqu’au serveur
Si les primitives sont listées mais que rien ne se passe, vos journaux répondent. S’ils sont vides, le modèle n’a pas choisi d’appeler l’outil : le problème est dans le nommage ou la description. S’ils contiennent l’appel, il est en aval, dans les paramètres ou le système cible.
Étape 4 : que renvoie le système cible
Le diagnostic redevient classique. Un refus d’authentification indique un identifiant expiré ou mal transmis. Un refus d’autorisation, des droits insuffisants sur le compte technique. Une erreur métier, des paramètres qui ne correspondent pas à ce que le système attend.
| Symptôme observé | Où regarder en premier | Ce que cela indique le plus souvent |
|---|---|---|
| Le serveur n’apparaît pas dans l’hôte | Le lancement manuel, puis la configuration du client | Démarrage impossible, chemin erroné ou déclaration incorrecte |
| Le serveur apparaît mais n’expose aucune primitive | La phase de déclaration dans le code du serveur | Primitives non enregistrées, ou après l’ouverture de la connexion |
| L’assistant dit ne pas pouvoir répondre, journaux serveur vides | Le nom et la description des tools | Le modèle n’a pas identifié l’outil comme pertinent |
| L’appel arrive mais échoue immédiatement | La réponse du système cible, code et message | Authentification expirée, droits insuffisants ou paramètre manquant |
| L’appel réussit mais le résultat est inutilisable | Le format et le volume de la réponse renvoyée | Réponse trop volumineuse ou trop brute |
| Ça fonctionne en local, pas à distance | Le transport HTTP : URL, certificat, proxy, authentification | Un élément réseau ou d’authentification manque en distant |
Sans journalisation côté serveur, ce diagnostic est impossible. Journaliser l’appel reçu, les paramètres et le résultat coûte peu à la construction et fait gagner beaucoup ensuite. C’est l’exigence de toute automatisation de tâches web qui tourne sans surveillance permanente.
Sécurité et périmètre
Brancher un assistant ajoute un chemin d’accès à un système. Ce chemin est déclenché par du langage naturel, il peut être influencé par les contenus lus, et il exécute ce qu’il a le droit d’exécuter. Aucune de ces propriétés n’est disqualifiante, mais chacune demande une réponse explicite.
Le périmètre est la première protection
Ce qui n’est pas exposé ne peut pas être atteint par ce canal. Chaque tool ajouté élargit la surface, chaque resource élargit ce qui peut être restitué. La question avant chaque ajout n’est pas « est-ce que cela pourrait servir » mais « est-ce que quelqu’un en a besoin aujourd’hui ».
L’influence par les contenus lus
Le texte lu par un assistant peut contenir des consignes glissées à son intention. Un commentaire, un message dans un ticket, un document déposé par un tiers : tout contenu non maîtrisé peut porter une consigne destinée à orienter le comportement. Cette exposition ne s’élimine pas, on la contient : en limitant ce que les tools d’écriture peuvent faire, en n’accordant pas de droits étendus à un serveur qui lit des contenus externes, et en exigeant une confirmation humaine sur l’irréversible.
La réversibilité comme critère de conception
Classez vos tools selon une question simple : si cette action part de travers, combien coûte le retour arrière ? Créer un brouillon coûte une suppression. Modifier un contenu coûte la restauration d’une révision. Envoyer un message à un client ne se rattrape pas, supprimer sans corbeille non plus. Cette classification donne la liste de ce qui doit passer par une validation humaine.
Les données personnelles
Dès que le périmètre touche des données personnelles, des obligations s’ajoutent : savoir où les données transitent, qui y accède, ce qui est conservé et combien de temps. Le protocole ne dit rien de cela. Ce que le branchement doit permettre, c’est d’y répondre : cloisonner, tracer les accès, pouvoir couper rapidement. Ne comptez pas sur un outil pour vous délivrer une conformité, cadrez le périmètre avec les personnes compétentes.
Ce que MCP ne fait pas
Un protocole normalise un dialogue. Il ne fait pas le travail à la place des composants qu’il relie. Voici ce qu’il ne faut pas en attendre.
- Ce n’est pas un modèle : la qualité des réponses dépend de l’assistant et des contenus reçus, pas du canal.
- Ce n’est pas un agent : décider quoi faire, dans quel ordre et quand s’arrêter relève de la conception, traitée dans l’article agents IA.
- Ce n’est pas un moteur de recherche sémantique : interroger un fonds documentaire par le sens relève du RAG.
- Ce n’est pas un remplaçant d’API : le serveur s’appuie sur les interfaces existantes, il ne les invente pas.
- Ce n’est pas un système de droits : les autorisations restent définies dans le système cible et dans votre serveur.
- Ce n’est pas un ordonnanceur : faire tourner une tâche à intervalle régulier relève de l’automatisation, pas du protocole.
- Ce n’est pas une garantie de sécurité : il définit un dialogue, pas une politique d’accès, qui reste à écrire.
Les erreurs fréquentes
Les difficultés rencontrées lors d’un branchement se ressemblent d’un projet à l’autre.
- Tout exposer parce que c’est possible. Le serveur devient difficile à sécuriser et paradoxalement moins efficace : plus il y a d’outils proches, plus la sélection devient ambiguë.
- Écrire des descriptions vagues. La description est l’interface entre votre système et le modèle : elle doit dire ce que fait l’action, ce qu’elle attend et quand elle convient.
- Aller directement en production. La vitesse d’installation n’a jamais rendu une erreur d’écriture moins coûteuse : imposez-vous un environnement d’essai.
- Réutiliser un compte administrateur. Cela fonctionne tout de suite, supprime toute possibilité de restreindre et rend les journaux illisibles.
- Confondre le serveur et l’assistant. Quand une réponse déçoit, la cause peut être dans la formulation de la demande ou la description d’un outil.
- Négliger la sortie renvoyée. Une réponse brute et volumineuse sature le contexte. Renvoyez ce qui sert, avec un message d’erreur qui explique quoi faire.
- Ouvrir un service HTTP sans authentification. Souvent le temps d’un test, puis oublié en l’état. Pour un essai rapide, préférez stdio.
Questions fréquentes
Faut-il savoir développer pour monter un serveur MCP
Écrire un serveur suppose de programmer. Mais ce qui détermine le succès du projet ne relève pas du code : définir le périmètre, formuler les descriptions, choisir les droits, décider ce qui exige une validation humaine. Une équipe métier peut porter cela et confier la réalisation. C’est ce qu’on travaille en formation aux agents IA, où le cadrage compte davantage que la syntaxe.
Un serveur MCP fonctionne-t-il avec n’importe quel assistant
Il fonctionne avec les applications hôtes qui implémentent le protocole côté client : le serveur n’a pas à connaître son interlocuteur, c’est l’intérêt d’un protocole ouvert. Quels produits l’implémentent, et dans quelles offres, se vérifie dans la documentation en vigueur de chaque éditeur, car cela évolue.
Faut-il choisir stdio ou HTTP dès le départ
Non, il est même préférable de ne pas trancher tout de suite. Commencer en stdio permet de valider le périmètre et les descriptions sans monter d’infrastructure. Le passage en HTTP se décide quand plusieurs personnes doivent utiliser la connexion : la logique métier reste la même, c’est l’enveloppe de sécurité qui s’ajoute.
MCP remplace-t-il les automatisations existantes
Non. Une automatisation classique exécute une séquence connue, à un moment connu, sans interprétation : c’est ce qu’il faut pour les tâches répétitives décrites dans l’article sur les tâches automatisables par un webmaster. MCP sert quand la demande est formulée en langage naturel et varie. Les deux cohabitent bien.
Peut-on brancher un système qui n’a pas d’API
Pas directement : le serveur doit atteindre le système par un moyen programmable. Selon les cas, il faut activer une interface existante mais non utilisée, construire une couche intermédiaire, ou s’appuyer sur des exports pour la lecture. Ce chantier se traite avant le branchement.
Comment savoir si un serveur est prêt pour la production
Quatre vérifications donnent une bonne indication. Chaque tool a-t-il été essayé avec des paramètres corrects, incorrects et absents ? Les journaux permettent-ils de reconstituer ce qui s’est passé ? Les actions non réversibles passent-elles par une validation humaine ? Sait-on couper l’accès rapidement ? Si l’une des réponses est non, le serveur reste en environnement d’essai.
Un test à faire aujourd’hui
Choisissez un système, un seul, et un périmètre étroit. Exposez-le en lecture seule, en stdio, avec deux ou trois primitives au maximum. Sur WordPress : les articles publiés d’une seule catégorie. Sur un outil de gestion : la consultation d’une fiche par son identifiant. Sur une base documentaire : un dossier partagé.
Posez ensuite trois questions : une question factuelle dont vous connaissez la réponse, une qui demande de croiser deux éléments du périmètre, et une qui en sort volontairement. La première vérifie que le canal fonctionne. La deuxième montre si vos primitives sont exploitables. La troisième dit comment le dispositif se comporte quand il ne peut pas répondre. Notez ce qui a fonctionné, ce qui a manqué et ce qui a surpris : c’est le vrai cahier des charges de la suite.
Pour aller plus loin
L’ensemble du sujet est organisé autour de la page agents IA et MCP. Côté usages visibles par le visiteur, les pages chatbot IA et recherche intelligente montrent ce qu’un site peut proposer une fois ses données accessibles, et la page intégrer l’IA à un site web replace le tout.
Pour monter en compétence avec votre équipe, les formations Claude et ChatGPT couvrent les usages quotidiens, et la formation Claude Cowork s’adresse à ceux qui travaillent déjà dans un environnement connecté.
- Chatbot IA pour entreprise : pour voir ce que devient un branchement une fois qu’il sert à répondre aux clients, et comment son prix se construit.
- Créer un agent IA pour son entreprise : pour replacer le serveur que vous exposez dans un projet plus large, outillage et budget compris.
Le catalogue est sur la page formations IA.
Si vous avez un système précis à brancher, le plus simple est d’en parler : décrivez votre contexte via le formulaire de contact ou demandez un devis. Les modalités figurent sur la page tarifs, et les autres articles sont regroupés sur le blog.